Hello Agent
一句话说清 Agent 与普通对话 AI 的差别,并沿 LLM→Prompt→Tool→MCP→Agent→Skill 的顺序把十个核心概念串成一条链。
目录
你大概已经习惯了这样的 AI:问一句、答一句。它确实好用,但当你把一件"要动手做完"的事交给它时,聊天窗口就开始吃力了。这篇文章讲清两件事:Agent 和普通对话 AI 到底差在哪,以及 LLM、Token、Context、Prompt、Tool、MCP、Skill 这些名词是怎么一层层搭起来的。
一、从"一问一答"到"持续干活"
普通对话的结构很简单:一问一答。你问一个问题,大模型给出回答,任务就结束了。举个例子——你说"帮我写一封邮件",模型把邮件写完,输出一次之后就没有后续了。它本质上是一台问答机器。
Agent 则不一样。它有一个持续运转的结构,也就是常说的 ReAct(Reasoning + Act + Observe)循环:你给它一个任务,它会先拆解,决定第一步做什么、第二步做什么,然后调用工具、检查结果,如此往复,直到任务完成——或者由它自己判断终止(比如超出循环次数、碰到 Token 上限、反复得到相同结果,则判定失败)。
ReAct 这个名字来自三个核心动作,三者构成一轮循环:
- 思考(Reasoning):拆分任务、做推理。"我还缺什么信息?下一步做什么?"
- 行动(Act):调用工具干活,搜索、读文件、执行代码、操控浏览器都算。
- 观察(Observe):检查工具返回的结果,判断任务有没有完成。
两种结构摆在一起看,差别一目了然:
普通对话:  你提问  →  模型回答  →  结束

Agent:     你提问  →  思考  →  行动  →  观察
            (观察完回到思考,如此循环,直到任务完成或者判定失败)
观察之后回到思考,再行动、再观察。有一点值得特别强调:ReAct 不是某个开发库独有的东西,而是一套通用的 Agent 循环工作标准。
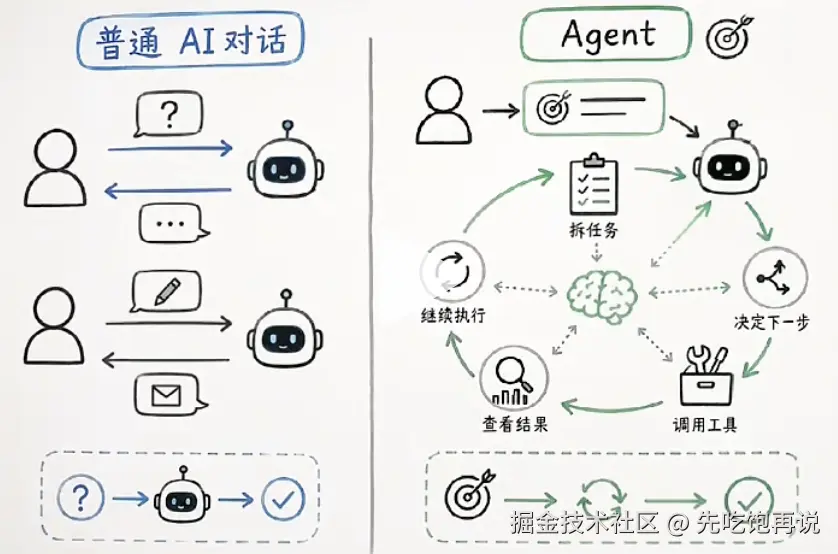
这里有个容易被忽略的关键点:每一轮都是大模型在做决策。开发者没有把调用顺序写死,是模型自己在循环里判断"还需要什么""下一步用哪个工具"。这也是它和"普通 API 调用"最本质的区别。
顺带一提,还有一种主观判断:有人认为 Claude 在 Coding Agent 领域领先,理由是它在"观察"这一环做得最好,有较完整的工程化验收机制——模型写代码、模型自己验证。这属于个人观点,可以听,不必当成定论。
二、概念链:LLM 到 Prompt
这些名词不是平级的,而是一层层往上搭。有一组很贴切的类比:LLM 是发动机,Token 是气缸里最小的燃料单位,Context 是燃料舱(Context Window 是燃料舱容量),Prompt 是油门指令。
LLM:一切的发动机
LLM(Large Language Model,大语言模型)简称"大模型"。现代大模型基本都基于 Transformer 架构,而这一架构由 Google 团队在 2017 年的论文《Attention Is All You Need》中提出;2022 年底 OpenAI 发布 GPT-3.5,被普遍视为第一个真正达到"可用级"的模型;2023 年 3 月 GPT-4 发布。
它的底层原理相当朴素,可以形容为一场文字接龙游戏:逐字逐句预测下一个概率最高的词,再把新词拼回输入继续预测,直到输出一个结束标识符。你在对话框里看到答案"一个字一个字地蹦出来",不是装酷,而是它底层就是这么算的。文字接龙的过程大致是这样(示意):
输入:今天天气
预测下一个词:真 / 很 / 不 …… → 取概率最高的「真」

输入:今天天气真
预测下一个词:好 / 热 / 冷 …… → 取「好」

输入:今天天气真好
预测:<EOS>(结束标识符)      → 停止输出
每一步只往前挪一个字,新词拼回输入后继续预测——这就是"蹦字"的全部原理。
Tokenizer:人话与机器语的翻译官
大模型本质是一个庞大的数学函数,内部跑的是矩阵运算——吃进去数字,吐出来的也是数字,它并不认识人类写的文字。所以中间需要一个翻译官,就是 Tokenizer(分词器)。它的职责有两步。第一步是编码(Encode),把文字切成 Token 并映射成数字编号(Token ID);第二步是解码(Decode),把模型吐出的数字还原成文字。
放到代码里,这两步大致是这样(示意):
text = "Hello, 世界"

ids = encode(text)     # 编码:文字 → Token → 数字编号
                       # 例如 [15496, 11, 11410, 5373](数字仅示意)
print(ids)

back = decode(ids)     # 解码:数字 → Token → 文字
print(back)            # "Hello, 世界"
对模型来说,它自始至终只见过 ids 这串数字,文字是人这一侧的表示。
Token:模型处理文本的最小单位
Token 是模型自己学会的一套切分规则切出来的最小片段,模型是一个 Token 一个 Token 地接收、也一个 Token 一个 Token 地输出。
需要注意的是:Token ≠ 词。举个实测的例子——"程序员"是 1 个词,实际被切成 2 个 Token("程序"+"员");"马克的技术工作坊"则被切成 5 个 Token。一个可用的估算参考是:平均 1 个 Token 约等于 0.75 个英文单词,或 1.5~2 个汉字。由此可以得出一条实操建议:同一句话的中英文版本,Token 消耗差别很大,做 AI 应用要算 Token 账,而不是字数账。
切分的粒度可以直观感受一下(示意):
"程序员"            →  ["程序", "员"]                      →  2 个 Token
"马克的技术工作坊"   →  ["马克", "的", "技术", "工作", "坊"]   →  5 个 Token

注意:标点、空格、换行同样会占 Token,它们不是"免费"的。
同一段话,换个模型(切分规则不同)Token 数就会变——所以估算只能当参考,不能当精确账。
Context 与 Context Window
Context(上下文)是模型每次处理任务时接收到的信息总和——历史对话、系统规则、当前输入都算在内。这里有一个关键认知:大模型并没有真正的记忆。它不像人那样"记得"你先前说过什么,而是每次发消息时,程序把之前的整段对话历史重新找出来、一起发给模型。这就是它看似"记得"的全部秘密。
Context Window(上下文窗口)则是 Context 最多能装的 Token 量。当历史记录加系统规则加当前输入超过这个上限时,超出的部分会被丢弃(通常是丢掉最久远的内容),模型于是"失忆"。目前通行的量级是:ChatGPT / Claude 的上下文窗口普遍在 128K~1M Token,比早期的几千 Token 扩大了数十上百倍,但原理没变。这也解释了两件日常现象:对话越长,每次请求要发的东西越多、成本越高;聊天太久,模型会把开头的事"忘"掉。
一次请求实际发出去的内容,大致长这样(示意):
{
  "system": "你是一名严谨的技术编辑,只回答与文档相关的问题。",
  "messages": [
    { "role": "user",      "content": "帮我看看这段说明有没有歧义" },
    { "role": "assistant", "content": "第三句的主语不明确……"    },
    { "role": "user",      "content": "第二段再改一下"           }
  ]
}
整包一起发,模型才"看起来记得"——而不是它脑子存了历史。超出 Context Window 时,被丢掉的通常是最早的几条。
Prompt:给模型的指令
Prompt 是当前给模型下达的具体指令或问题,分两类:
- User Prompt:用户自己打的字。
- System Prompt:开发者后台配置的"人设"和规则,像后厨贴的规矩——"不管顾客点什么,都得先问有没有忌口"。
System Prompt 之所以管用,是因为它每次都会作为系统规则被放进 Context,模型相当于手里拿着说明书干活。所以做稳定的应用,一个常见分工是:把"角色人设 + 硬性规则 + 输出格式"写进 System Prompt,把自由输入留给 User Prompt。落到文本上大致是这样(示意):
System Prompt(开发者配置,每次请求自动带上)
  角色:你是一名中文技术编辑
  规则:单句不超过 20 字;不确定的事实不写
  输出:先给修改稿,再列出改动点

User Prompt(用户本次输入)
  帮我改一下这段产品说明
同一个 User Prompt,配上不同的 System Prompt,得到的结果会明显不同——这就是"人设"的实际作用。
三、再往上一层:Tool 到 Skill
Tool:模型感知和影响外部环境的手
大模型有几个天生短板:算不准精确的数学、不知道实时信息(训练数据有截止时间,不知道今天的天气和股价)、也不能真的执行动作。对策不是让模型什么都会,而是让它知道该调用哪个工具、传什么参数,再把工具返回的结果拿回来继续推理:向外感知的如搜索、数据库查询,向外动作的如发邮件、下单。
工具好比 Agent 的手和脚:没有工具,模型只能在脑子里转,转完还是只有文字。所以一个 Agent 的能力边界,很大程度上取决于它接入了哪些工具——工具的覆盖范围,直接决定了它能干成哪些事。
模型看到的不是工具的代码,而是这样一份声明(示意):
{
  "name": "get_weather",
  "description": "查询指定城市的当前天气",
  "parameters": {
    "type": "object",
    "properties": {
      "city": { "type": "string", "description": "城市名,例如:杭州" }
    },
    "required": ["city"]
  }
}
它按这份声明判断"什么时候该调、该传什么参数";至于工具背后怎么实现,模型不关心也看不到。
MCP:工具接入的"统一插座"
MCP(Model Context Protocol,模型上下文协议)解决的是一个很现实的麻烦。在它出现之前,各家模型厂商的工具接入格式互不相同:接 GPT 要按 OpenAI 的格式写一套,接 Claude 要按另一套再写一遍,每适配一个模型就要维护一遍,成本很高。
可以用"各国插头"来类比:10 件家电配 10 个国家的插座,就要买 100 个转换头;MCP 相当于定义了统一插座,工具开发者只按一个标准做一次,所有支持该标准的模型都能即插即用。也可以把它理解成 AI 界的 USB-C。(具体协议与开源项目这里不展开)
一份 MCP 配置大致长这样(示意):
{
  "mcpServers": {
    "filesystem": {
      "command": "npx",
      "args": ["-y", "@modelcontextprotocol/server-filesystem", "/path/to/dir"]
    }
  }
}
填一次,所有支持该协议的客户端都能接上——换模型不用重写,这正是"统一插座"省下来的成本。
Agent:能自主干活的程序
Agent(智能体)是能自主规划、自主调用工具、持续运作,直到解决用户问题的一个程序。它和"LLM + Prompt"的普通用法差别可以列成一张表:
| 维度 | 普通用法(LLM + Prompt) | Agent |
|---|---|---|
| 规划 | 几乎没有,要用户一步步喂 | 自主拆解任务、制定计划 |
| 工具 | 用户手动切换 | 自主决定何时调用哪个工具 |
| 持续运作 | 一轮对话结束即停 | 不达目标不罢休,可多轮迭代 |
一个贴切的比喻是"自动售货机 vs 实习生":售货机投币、选饮料、出饮料,一步到位,绝不主动多做一件事;实习生接到"帮我组织一场周五团建",会自己列计划、查天气,发现周五下雨就自动把室外 BBQ 改成室内餐厅,最后交给你一份完整方案。
同一件事换成 Agent 跑一遍,中间过程大致是这样(示意):
任务:查一下周五杭州的天气,如果下雨就把团建改到室内。

思考  得先知道天气 → 调用天气工具
行动  get_weather(city="杭州", date="周五")
观察  {"condition": "中雨", "temp": "18~24℃"}

思考  下雨了,要换室内场地 → 查询可用场地
行动  list_venue(type="indoor")
观察  ["城南会议室(30 人)", "滨江活动室(15 人)"]

思考  信息够了,可以给结论
输出  建议改到城南会议室:容量 30 人,周五下午有空档。
注意:这里没有任何一步是开发者写死的。走几步、调用哪个工具、什么时候停,都是模型自己在循环里决定的。
Agent Skill:给 Agent 看的"说明书"
Skill(技能)是一份给 Agent 看的说明文档,作用是把某个领域的做事规范固化成一份文档——Agent 按文档执行,从而稳定、可复用,而不是每次靠运气。
一份 Skill 通常分两层:元数据层(name 技能名、description 技能描述,给 Agent"认路"用)和指令层(目标、执行步骤、判断规则、输出格式、示例)。指令层的写法不强制,讲明白就行;但有两条硬性规范——在指定的 skills 目录下建一个文件夹,文件夹名必须与技能名一致,文件夹里必须有一个名为 SKILL.md 的文件。
真正巧妙的是加载机制,这种机制叫渐进式披露:Agent 启动时只读元数据(内容小、加载快),只有当用户的问题与这个 Skill 的名称、描述相关时,才去读体积可能很大的指令层。这能省下大量 Token。举个"出门清单"Skill 的例子:用户说"我要出门了,告诉我带什么",Agent 判断与技能描述相关后读取全文,按文档规定先调用定位工具拿经纬度,再调用天气工具,最后按"下雨带伞、气温低加外套、紫外线强带防晒"的规则给出清单。
那份 Skill 文件本身,大致长这样(示意):
---
name: out-the-door-checklist
description: 用户准备出门时,按天气给出带伞、加衣、防晒建议
---

# 出门清单

## 步骤

1. 调用定位工具,拿到当前经纬度
2. 调用天气工具,查询当日天气
3. 按规则生成清单:下雨带伞;气温低加外套;紫外线强加防晒
上半部分是元数据层(name 与 description,Agent 启动时就读,用来"认路");下面是指令层(真正干活时才读)——这就是渐进式披露在文件结构上的样子。
Skill 也有选型问题。一份前端与 UI 设计技能清单提到:Anthropic 构建的 frontend-design 约有 27.7 万次安装,它会在写代码前先逼 Agent 定下一个大胆的设计方向,避免千篇一律的"AI 味"界面;但正因它追求新方向,在已有设计体系的旧项目上可能覆盖你原有的设计 token。要沿用既有品牌,就该配 brand-guidelines;要在 shadcn/ui + Tailwind 上保证组件准确,则用 shadcn-context;要给已有应用快速统一主题、一次性生成并套用整套设计 token,则用 theme-factory。这也说明 Skill 是"说明书"而非万能药,用错了方向反而添乱。
四、常见误解与边界
第一,Agent 不等于更聪明的模型。有句话点得很透:Agent 不是"更聪明的 LLM",而是"会循环的 LLM"。结构上的差异,往往比模型本身的智能更重要。
第二,工具不是越多越好。工具多确实能干更多事,但这里也留了一个反问——有没有"工具太多反而坏事"的情况?工具越多,模型选错工具的概率和维护成本都会上升。所以接入工具的数量只是一个指标,还得看它选得准不准。
第三,Skill 本身不产生能力,它约束做法。写得好能让输出稳定可复用,写得含糊或方向不对反而拖后腿——前面 frontend-design 可能覆盖已有设计 token,就是一例。
第四,不是所有事都该交给 Agent。一问一答能解决的简单任务,用对话就够了;循环、工具调用、多轮迭代都有代价。ReAct 循环也会因为超轮次、超 Token、结果重复而终止并判定失败,并非"给了任务就必然完成"。